RUITA / DAILY BRIEF ·
视频模型转身就忘了房间?World-T³ 用“场景记忆”接住前后画面
World-T³ 为视频生成加入可更新的场景记忆,尝试解决镜头转开再回来时房间布局变样的问题。作者在 120 段往返镜头中报告了更稳定的画面;单张 B200 上测得 20.6 帧/秒。
KEY FACTS
核心信息
- 01
论文10月12日提交arXiv,作者来自Meta Reality Labs、伊利诺伊大学芝加哥分校和布朗大学;目前为预印本。
- 02
作者构建120段10秒、1280×704的往返镜头基准;在同一初始画面、文字和相机轨迹下比较多个模型。
- 03
作者报告返回画面的PSNR从最强对照的13.52 dB升至18.31 dB;单张B200、30秒视频设置下测得20.6帧/秒和54GB峰值显存。
用场景记忆接住镜头转开后的画面
视频模型通常依赖有限的上下文记住前面出现过的物体。World-T³ 把观察到的场景特征存进固定大小的记忆,并按相机位置取回;镜头离开房间、转向别处再回来时,模型可以继续使用先前记录的布局,而不是从头猜一遍。研究团队还把较慢的教师模型蒸馏成少步生成器,以便更快地产生画面。
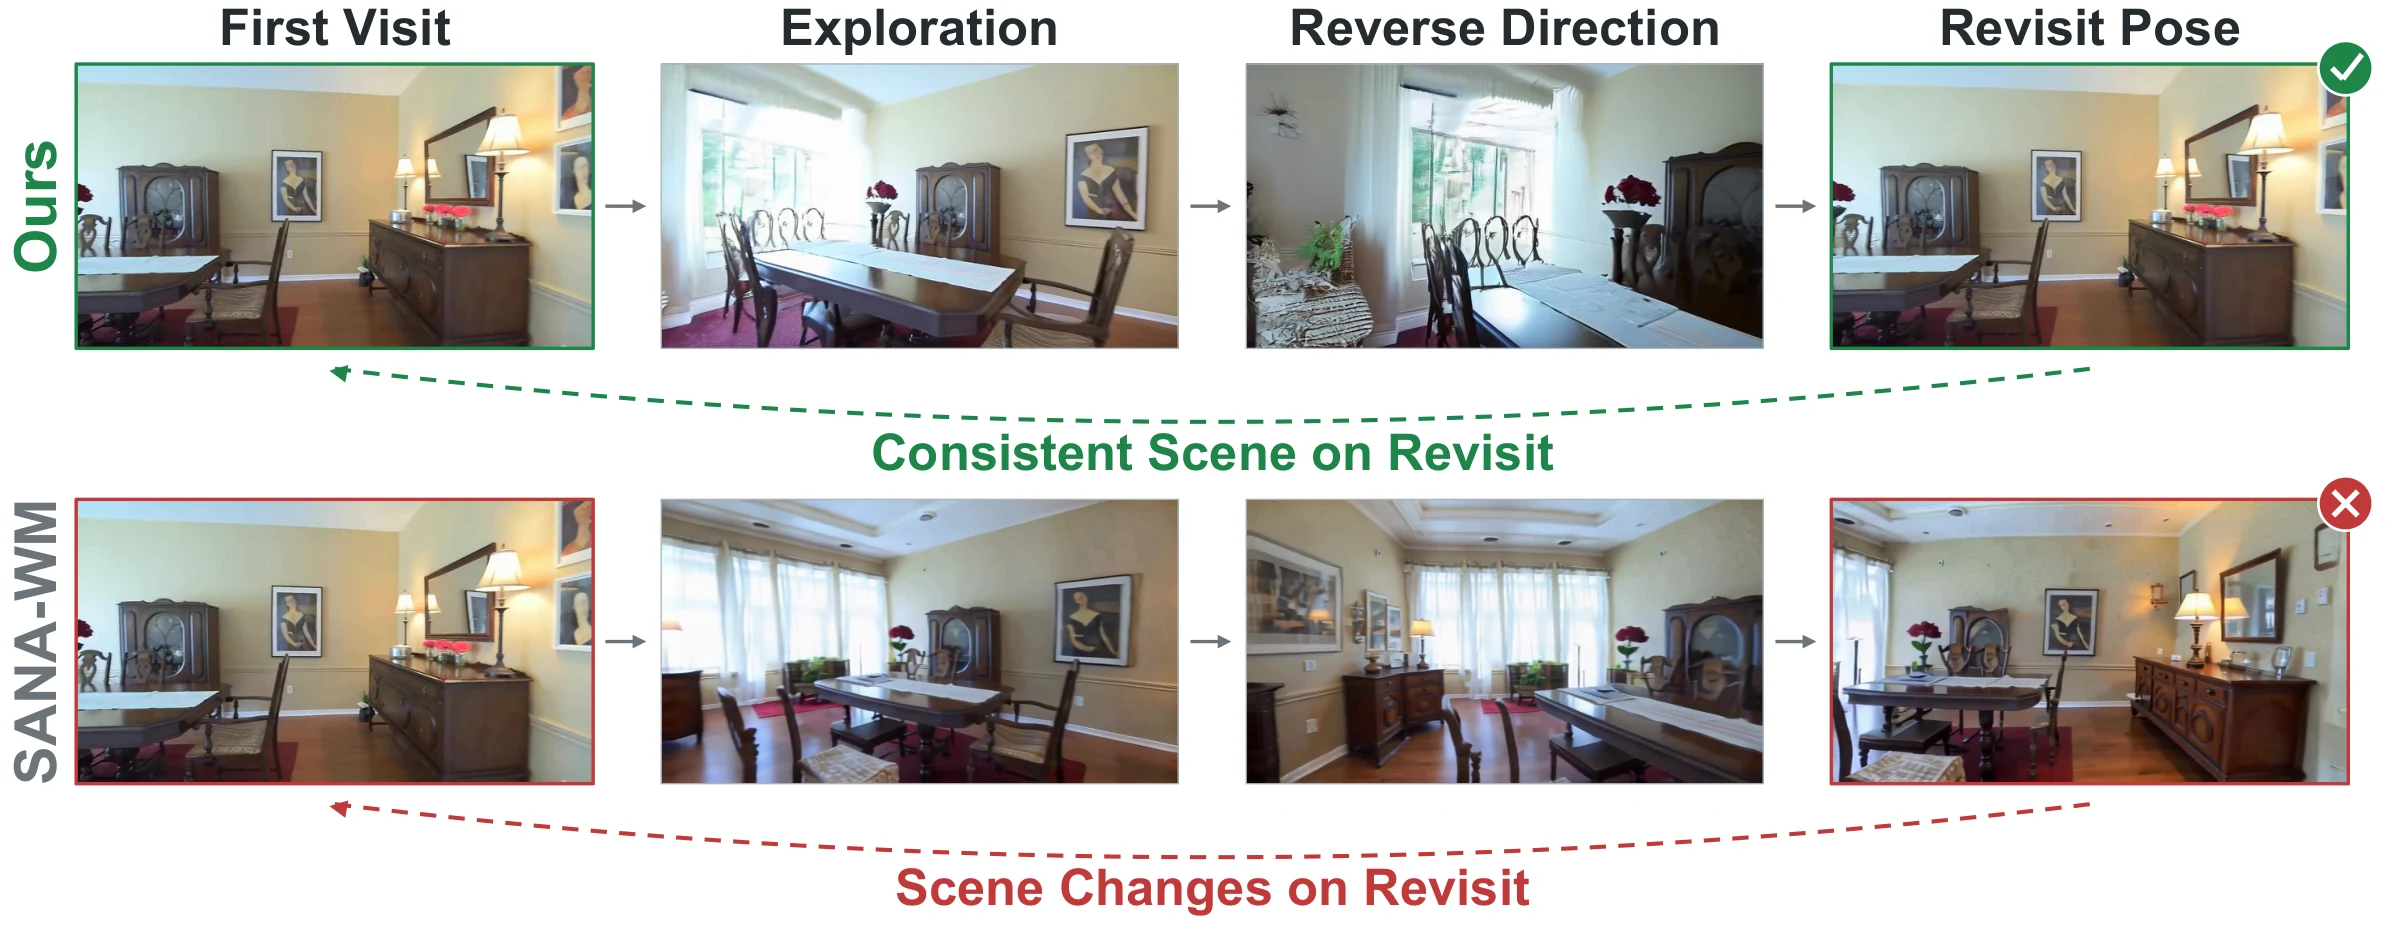
回到同一视角时,画面能不能接上
论文让模型在 120 段、每段 10 秒的视频中把镜头转开再折回,比较返回画面和相机轨迹。World-T³ 的回访 PSNR 为 18.31 dB,对照为 13.52 dB;单张 NVIDIA B200 在 1280×704 分辨率下约每秒生成 20.6 帧。对机器人训练、虚拟实验和连续场景模拟来说,关键价值是模型能否在多轮观察中保持同一空间的记忆。
如果用于机器人或虚拟实验,团队可以设计“离开—返回—再次定位”任务,检查同一物体的形状、位置和相机轨迹是否连续。相比只看单帧画面,这种测试更接近真实空间中的持续观察。