RUITA / DAILY BRIEF ·
AI 能判断研究点子新不新?改一句提示词,GPT-5.4 判定率从 93.5% 跌到 40.9%
Allen Institute for AI 发布 Novelty-Bench,整理研究提案和论文材料,测试 AI 是否能像研究者一样判断新颖性。它把“看起来新”拆成可比较的评测任务,供团队检查模型评审与人工判断的差异。
KEY FACTS
核心信息
- 01
Ai2 比较了六个大模型,在逐项打分和两两比较两种方式下测试新颖性判断。
- 02
在“人类想法与 AI 生成想法”配对中,GPT-5.4 的一个提示词变化让准确率从 93.5% 降至 40.9%,同一批配对中超过一半的判定改变。
- 03
研究团队还改变推理预算、文献检索和呈现格式;不同设置没有一种始终最优。
改一句提示词,同一批想法就换了判分
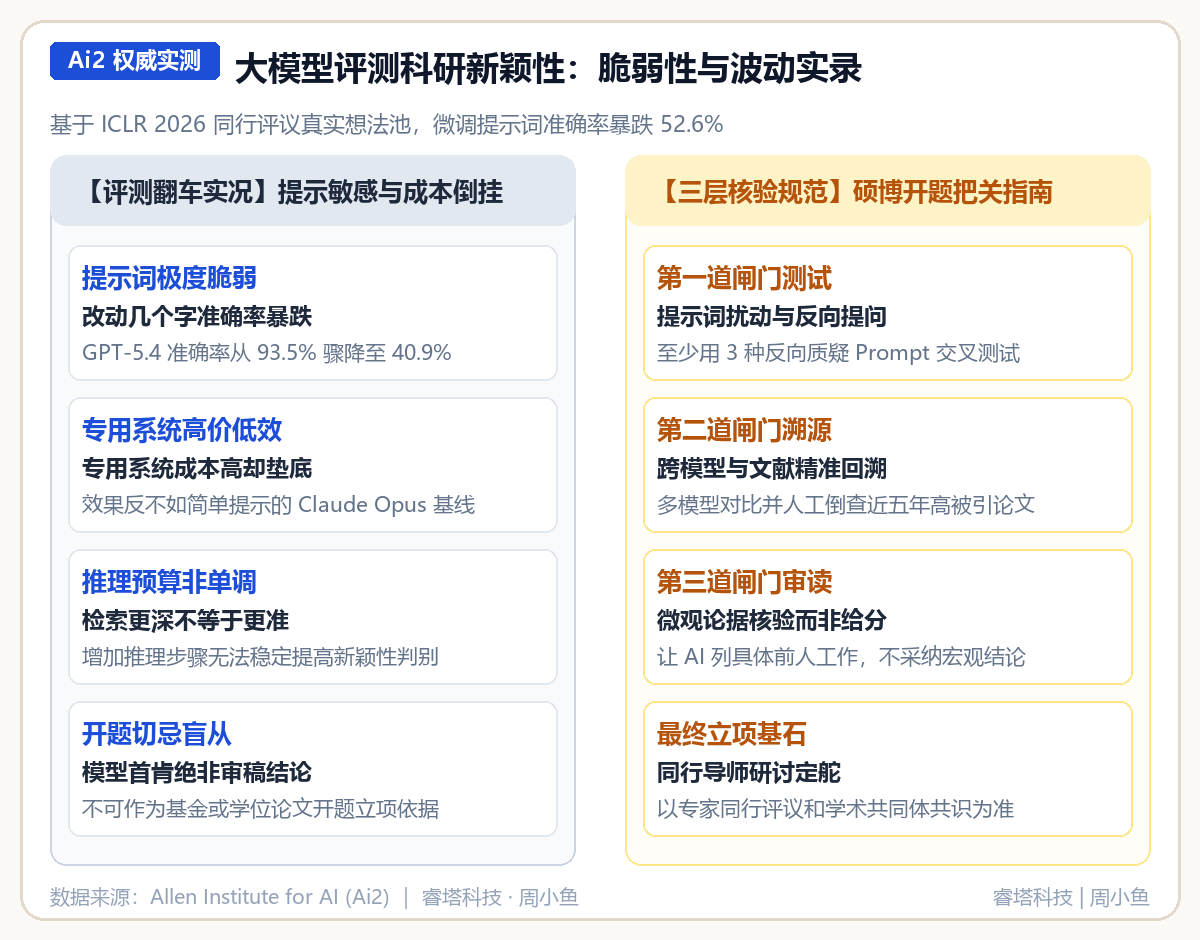
Allen Institute for AI 用研究提案和论文材料制作 Novelty-Bench,比较六个大模型在新颖性判断上的表现。研究团队只改变题目说法:一版告诉模型每对想法恰有一个已被评审认为新颖,另一版只问哪个想法更有新意。GPT-5.4 在其中一组人类与 AI 生成想法的比较中,准确率从 93.5% 降到 40.9%,超过一半的成对判定发生变化。
让模型列出相近研究,再由研究者核对
选题团队可以让 AI 先找最接近的论文,再逐项说明研究问题、方法和数据有什么差异;同时保存提示词和检索结果,用另一种问法再跑一遍。如果两次判断变化很大,就回到原论文核对。这样能用 AI 扩大搜索范围,又不会让一句提示词替团队决定选题。
Ai2 同时调整了推理预算、检索和呈现格式,模型的排名并没有因某项设置增加就稳定变好。研究组可以用同一批选题跑不同提示,再检查“模型说新”的依据是否真能在相关工作中找到。