RUITA / DAILY BRIEF ·
Anthropic:1,000 个 Fable 5.2 智能体用 30 小时完成费马大定理 Lean 形式化
Anthropic 称,约 1,000 个 Claude Fable 5.2 智能体在 30 小时内把费马大定理的已有证明写成 Lean 可检查的形式。相较首次尝试,行动 token 用量约为三分之一、证明短七倍;同样规模的 Opus 5.5 单次测试在 18 小时完成 26%。
核心信息
- 01
Anthropic 于 2026 年 11 月 9 日发布 Claude Fable 5.2 和 Claude Mythos 5.2;两者使用同一底层模型。
- 02
公司称,约 1,000 个 Fable 5.2 智能体用 30 小时完成费马大定理的 Lean 形式化,人工干预较少。
- 03
与 Anthropic 首次形式化相比,这次行动 token 用量约为三分之一,最终证明长度约为七分之一;首次尝试耗时 11 天并有研究人员指导。
- 04
在同样约 1,000 个智能体的单次对比中,Opus 5.5 用 18 小时完成了 26%,30 小时后进展不大。
- 05
Anthropic 发布了 Lean 4 与 Mathlib 上的机器检查证明代码仓库。
AI 做的是“把证明翻译成电脑能检查的步骤”
数学形式化,是把数学证明写进 Lean 这类证明助手,让计算机按规则检查每一步。费马大定理本身早已有证明;这次工作是把已有证明转成机器可检查的形式。
Anthropic 称,约 1,000 个 Fable 5.2 智能体从少量提示和一组中间定理陈述开始,在 30 小时内完成形式化,过程中没有使用数学参考资料。Anthropic 随后公开了基于 Lean 4 和 Mathlib 的机器检查证明仓库。
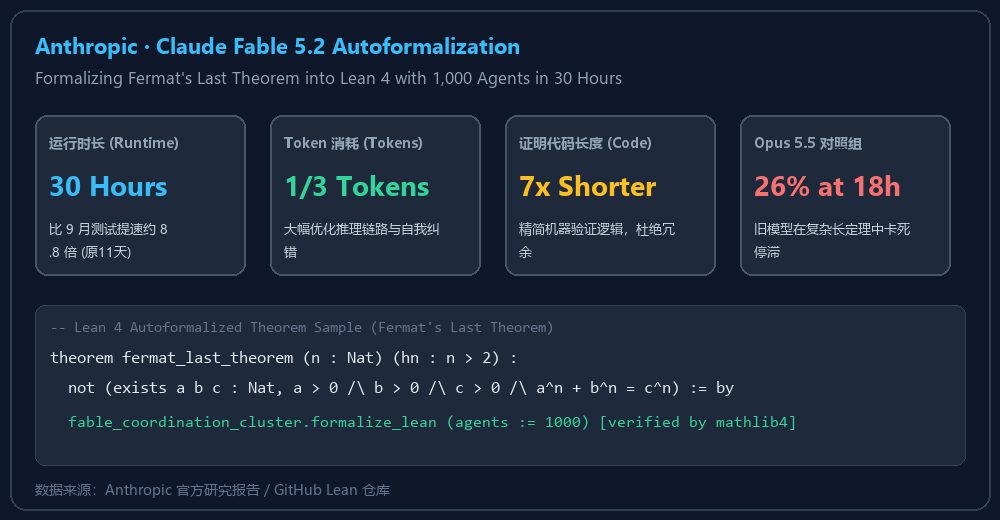
Anthropic称其测试每个模型各运行一次;Fable 5.2 使用的行动 token 为首次形式化的三分之一。
对科研团队更现实的启发:让 AI 接手重复的验证工作
Anthropic 报告称,这次形式化使用的行动 token 约为首次尝试的三分之一,证明长度约为首次结果的七分之一。首次尝试使用尚未发布的研究版 Claude、专门设计的工作框架和研究人员指导,耗时 11 天。
作为对比,同样约 1,000 个智能体设置下,Opus 5.5 在 18 小时完成 26%,之后到 30 小时只增加少量进度。Anthropic 说明每个模型只进行了一次运行,因此这组数据适合了解一次任务的进度,不代表多轮重复后的平均表现。